 韩澈·2026-10-16
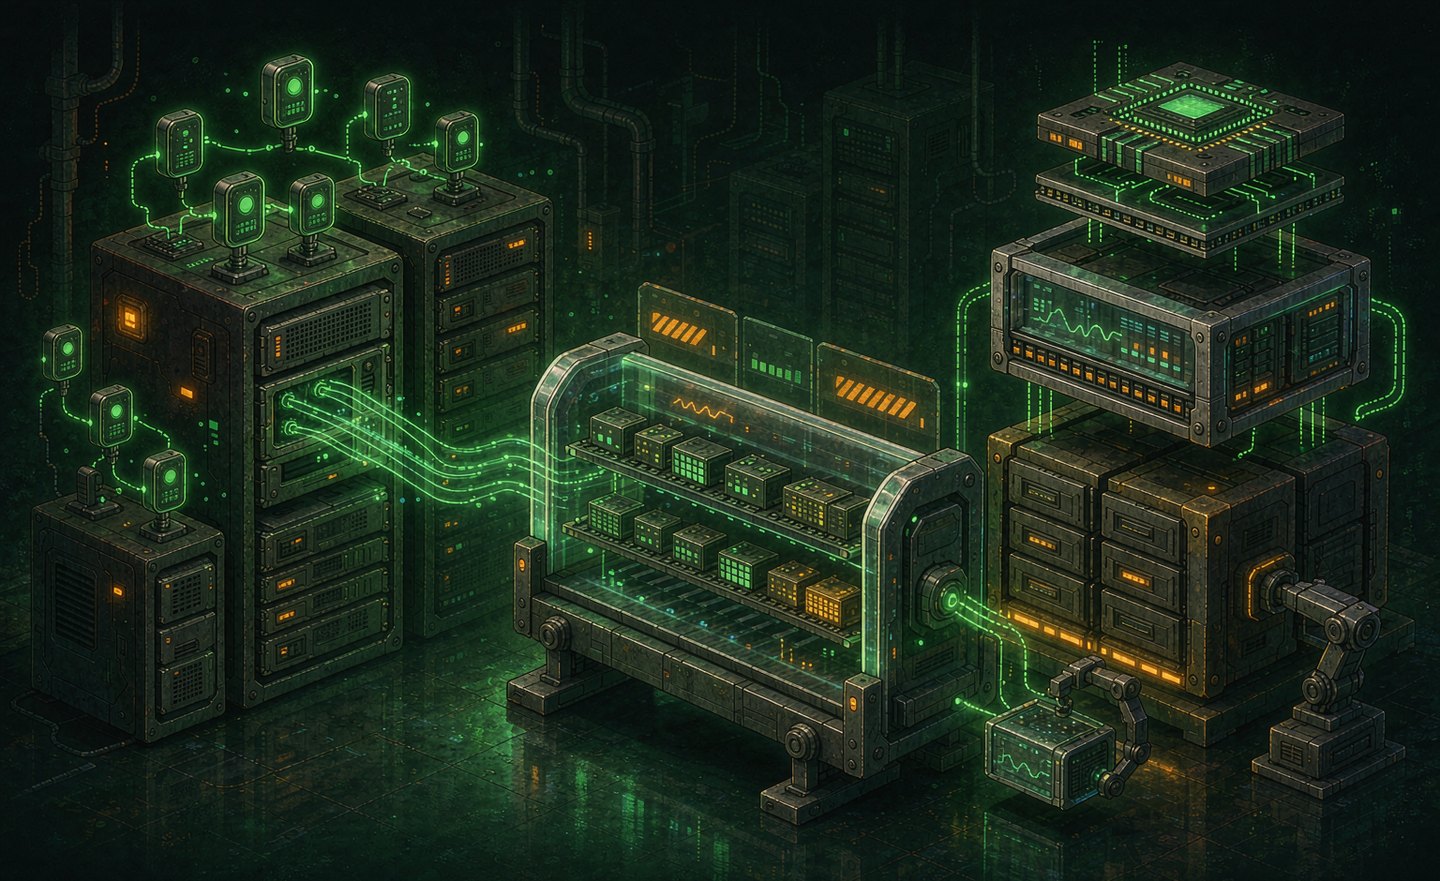
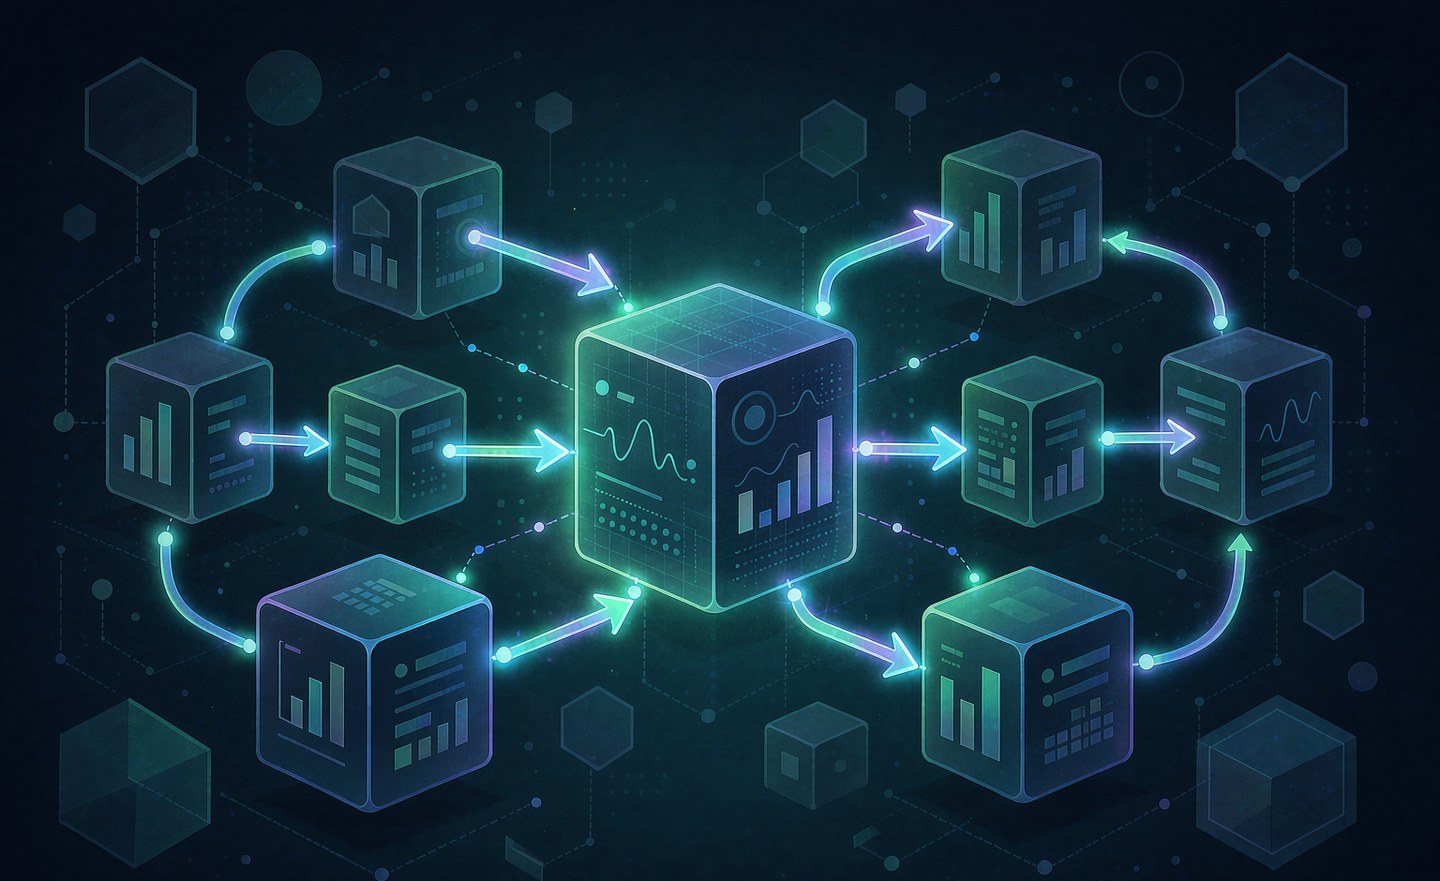
日志链路是一条数据管道:应用产生事件,采集端读取,传输层削峰,存储层建立索引,查询端再按条件检索。任何一段都可能限流或中断。设计重点不是“能看到日志”,而是在业务高峰与局部故障下,日志不反向阻塞业务,并能说明丢失、重复与延迟的边界。 两种 Agent 采集模式 读文件 tail 模式由节点 Agent 监听日志文件,记录文件标识和读取偏移。它适合传统进程、需要本地落盘审计的场景,也便于应用与采集器解耦。难点在于轮转、截断、符号链接、容器短生命周期和磁盘占满。仅按文件名保存偏移会在轮转后读错对象,应同时识别文件系统标识,并处理“旧文件已重命名但仍有未读内容”。 应用写 stdout/stderr 是容器环境的常用方式。应用无需知道后端地址,容器运行时把输出写入节点日志,Agent 再统一采集并补充 Pod、命名空间和容器标签。这里的“直推 stdout”并不代表同步发送到远端;stdout 仍需经过运行时与节点采集链路。若日志产生速度长期超过节点写盘和采集能力,容器日志同样可能占满磁盘。 缓冲、背压与投递语义 采集端到传输层之间需要内存队列吸收短暂抖动,磁盘队列覆盖较长中断。内存缓冲快但进程退出即丢失,磁盘缓冲更耐故障,却要设置容量、刷盘与淘汰策略。队列达到上限时必须明确选择:丢弃低等级日志、采样、暂停读取文件,或把事件转移到隔离区,不能让行为取决于内存耗尽。 业务写日志不应同步阻塞远端传输。若后端变慢,背压应停留在采集链路,不能一路传回业务请求。对本地文件 tail,Agent 可以暂停读取,待后端恢复后按偏移补采;前提是文件在等待期间没有被轮转删除,且磁盘保留足够空间。 常见实现提供至少一次投递:发送后若确认响应丢失,Agent 会重发,于是存储端可能出现重复。可以为事件生成稳定 ID 去重,但全局去重会增加写入成本。多数运行日志接受少量重复,并通过时间、实例、偏移或事件 ID 辅助判断;要求严格一次的场景需要端到端事务语义,成本与复杂度都更高。 buffer: type: disk max_size: 8GiB flush_interval: 1s on_full: drop_debug_then_oldest retry: max_backoff: 30s jitter: true 配置值只是结构示例,容量应根据峰值写入量、可容忍中断时长和节点磁盘预算计算。 多行日志必须在采集端合并 Java 堆栈、解释器异常和某些数据库错误会跨多行输出。若每行作为独立事件,异常类型、调用栈与请求上下文会分散,查询也难以还原。合并规则通常把“符合时间戳开头的行”识别为新事件,其余缩进行追加到当前事件: 新事件开头:^d{4}-d{2}-d{2}Td{2}:d{2}:d{2} 续行示例:^s+ats|^Caused by:|^s*... d+ more 规则应在靠近源头的 Agent…